검색·GEO
AI 검색이 회사 소개를 잘못 읽는 이유와 고치는 순서
ChatGPT·Perplexity·네이버 AI 검색에 「디지털다임은 어떤 회사야?」라고 물으면, 도구는 웹에서 관련 페이지를 모아 읽고 요약해 답합니다. 답 아래에는 근거로 쓴 페이지 주소가 붙습니다. 회사가 직접 운영하는 사이트는 이때 가장 중요한 근거입니다. GEO(Generative Engine Optimization, 생성형 검색 최적화)는 AI 답변에 회사 정보가 정확히 실리도록 사이트를 정리하는 일입니다.
검색 결과 순위를 다루는 SEO와 겹치는 부분이 많습니다. 차이는 목표입니다. SEO는 검색 결과에서 눈에 띄는 것, GEO는 AI가 만든 문장 안에 맞는 사실로 인용되는 것을 목표로 합니다.
잘못 읽는 다섯 가지 이유
- 이름 표기 혼재「디지털다임」 「D2」 「digitalDigm」이 페이지마다 따로 쓰이면 서로 다른 회사로 읽히거나, 이름이 비슷한 다른 회사 정보가 섞입니다
- 그림 속 정보설립 연도, 주요 고객, 수상 내역이 이미지나 스크립트로 그린 화면에만 있으면 글로 읽히지 않습니다
- 갈라진 주소같은 내용이 여러 주소에 있거나 옛 페이지가 살아 있으면 어느 쪽이 최신인지 판단하지 못합니다
- 기준일 없는 숫자「임직원 OO명」 「누적 OO건」에 기준일이 없으면 몇 년 전 값이 그대로 인용됩니다
- 수집 차단robots.txt에서 AI 검색 수집기를 막아 두면 그 도구의 답에서 회사가 빠집니다
1단계 — 진단: 질문 목록부터 만든다
무엇을 고칠지는 사람들이 AI에게 실제로 물을 질문에서 정합니다. 질문은 두 갈래로 나눕니다. 회사를 이미 아는 사람의 확인 질문과, 업체를 찾는 사람의 탐색 질문입니다. 질문마다 답이 되는 페이지를 하나씩 정해 두면 「질문 지도」가 됩니다.
| 갈래 | 질문 예시 | 답하는 페이지 |
|---|---|---|
| 확인 | 디지털다임은 어떤 사업을 하나요? | 사업 소개 |
| 확인 | DX와 AD 사업부는 무엇이 다른가요? | 사업 소개 |
| 확인 | FEZH는 어떤 곳인가요? | 사업 소개 · 확장 사업 |
| 탐색 | AI 서비스 구축 맡길 회사 추천해 줘 | AI · AI 서비스 구축 |
| 탐색 | 서울에서 웹·앱 구축과 운영을 함께 하는 곳 | 플랫폼 구축·운영 |
| 탐색 | GEO 대행할 수 있는 회사 | 검색·GEO 최적화 |
탐색 질문은 특정 회사를 고르는 답이 나와야 하므로, 분야·실적·위치 같은 회사 사실을 여러 페이지에 같은 표현으로 반복합니다. 표현이 페이지마다 다르면 AI는 서로 다른 주장으로 받아들입니다.
2단계 — 정본 주소
페이지마다 대표 주소(canonical) 하나를 정하고, 사이트를 바꾸며 없어지는 옛 주소는 새 주소로 자동 연결(301 리다이렉트)합니다. 옛 주소에 쌓인 검색 신호가 새 주소로 넘어가고, 같은 내용이 두 주소로 갈라지지 않습니다.
<!-- 페이지 머리말 -->
<link rel="canonical" href="https://www.d2.co.kr/about/">

# 서버 설정(Apache 예) — 옛 주소를 새 주소로
Redirect 301 /about/about /about/
Redirect 301 /news/newsletter /insights/newsletter/
3단계 — 페이지마다 다른 제목과 설명
제목(title)과 설명(description)은 검색 결과의 첫 줄이자 AI가 페이지를 요약할 때 먼저 보는 문장입니다. 모든 페이지가 같은 설명을 쓰면 구분되지 않습니다. 설명은 회사 이름과 그 페이지의 핵심 사실을 넣어 50자 이상으로 씁니다.
<title>사업 소개 | 디지털다임 digitalDigm</title>
<meta name="description" content="디지털다임은 1998년 설립한 통합 디지털 컴퍼니입니다. 웹·앱 구축과 운영(DX), 광고·캠페인(AD)을 한 회사에서 합니다.">
4단계 — 회사 정보를 기계가 읽는 형식으로
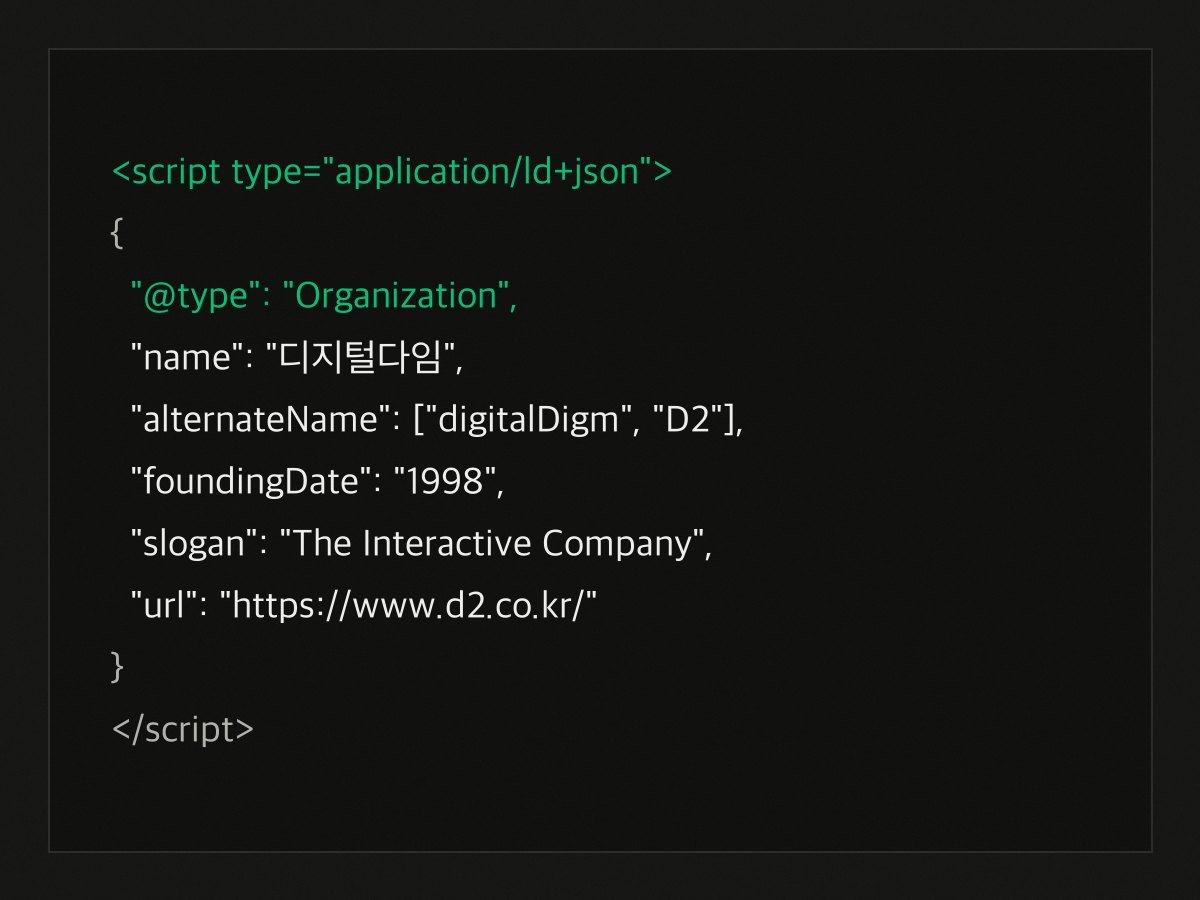
구조화 데이터(JSON-LD)는 사람이 보는 글과 별도로, 「이 회사의 이름·설립 연도·주소·사업」을 정해진 형식으로 적어 두는 방법입니다. 다른 표기(alternateName)를 함께 적으면 「D2」와 「디지털다임」이 같은 회사로 묶입니다. 사업부와 확장 사업도 회사의 일부로 연결할 수 있습니다.
{
  "@type": "Organization",
  "name": "디지털다임",
  "alternateName": ["digitalDigm", "D2"],
  "foundingDate": "1998",
  "address": { "streetAddress": "대사관로11길 41", "addressLocality": "용산구",
               "addressRegion": "서울특별시", "postalCode": "04400" },
  "department": [ { "name": "디지털다임 DX" }, { "name": "디지털다임 AD" } ],
  "knowsAbout": ["AI 서비스 구축", "웹·앱 구축", "디지털 광고", "생성형 엔진 최적화(GEO)"]
}
회사 정보는 사이트 안 한 곳에서만 관리하고 모든 페이지가 그 값을 가져다 쓰게 합니다. 값이 여러 곳에 흩어지면 1단계의 「이름 표기 혼재」가 다시 생깁니다.
5단계 — 화면에 보이는 문답을 그대로 데이터로
AI 답변은 질문과 답이 짝지어진 문장을 인용하기 쉽습니다. 사업 소개·회사 소개 페이지에 자주 묻는 질문을 두고, 같은 내용을 문답 데이터(FAQPage)로도 적습니다. 원칙은 하나입니다. 화면에 없는 문답은 데이터에도 넣지 않습니다. 사람이 보는 내용과 기계가 읽는 내용이 다르면 검색엔진 정책에 어긋납니다.
{ "@type": "Question", "name": "디지털다임은 어떤 사업을 하나요?",
  "acceptedAnswer": { "@type": "Answer",
    "text": "웹·앱 구축과 운영(DX), 광고·캠페인(AD)을 한 회사에서 합니다." } }
6단계 — 수집 파일: robots.txt · sitemap.xml · llms.txt
robots.txt는 어떤 수집기가 사이트를 읽어도 되는지 정하는 파일입니다. AI 검색 도구는 각자 수집기 이름이 있습니다. 검색용 수집기와 학습용 수집기가 따로 있어 허용 범위를 나눠 정할 수 있습니다.
# 검색·AI 검색용 수집기 허용
User-agent: Googlebot
Allow: /
User-agent: Yeti            # 네이버
Allow: /
User-agent: OAI-SearchBot   # ChatGPT 검색
Allow: /
User-agent: PerplexityBot
Allow: /

Sitemap: https://www.d2.co.kr/sitemap.xml
sitemap.xml은 사이트의 전체 주소 목록입니다. llms.txt는 AI가 사이트를 빨리 파악하도록 회사 정의와 주요 페이지를 한 장에 정리한 파일로, 최근 제안된 방식(llmstxt.org)입니다. 아직 모든 도구가 읽지는 않지만 해가 없고 만드는 비용이 작습니다.
# 디지털다임 digitalDigm
> 1998년 설립한 통합 디지털 컴퍼니. 웹·앱 구축과 운영(DX), 광고·캠페인(AD).

- [사업 소개](https://www.d2.co.kr/business/): DX·AD 사업부와 확장 사업
- [AI](https://www.d2.co.kr/ai/): AI 서비스 구축과 사내 AI 도구
7단계 — 숫자에는 기준일을
AI는 사이트에 적힌 숫자를 그대로 옮깁니다. 숫자 옆에 기준일을 붙여 두면 오래된 값이 최신 값처럼 인용되는 일을 줄일 수 있습니다. 예를 들어 「누적 수상 165+」보다 「누적 수상 165+(회사소개서 2026.01 기준)」이 안전합니다.
운영 — 매달 같은 질문으로 확인
적용한 뒤에는 1단계의 질문을 매달 같은 도구에 넣고 결과를 기록합니다. 검색엔진 등록 도구(구글 서치콘솔, 네이버 서치어드바이저)에서 색인된 페이지 수가 사이트맵 주소 수와 맞는지도 함께 봅니다.
| 질문 | 도구 | 회사가 나왔나 | 사실이 맞나 | 인용된 페이지 |
|---|---|---|---|---|
| 디지털다임은 어떤 회사야? | ChatGPT | 예 | 설립 연도 맞음 | /about/ |
| AI 서비스 구축 업체 추천 | Perplexity | 아니오 | — | — |
기록표 예시 · 실제 측정값이 아니라 기록 형식입니다
점검 목록
- 회사 이름 표기를 하나로 정하고, 다른 표기는 구조화 데이터의 alternateName에 모았다
- 설립 연도·주소·사업 같은 핵심 사실이 이미지가 아닌 글로 있다
- 페이지마다 대표 주소와 고유한 제목·설명이 있다
- 옛 주소는 301로 새 주소에 연결했다
- 문답 데이터는 화면에 보이는 문답과 같다
- robots.txt에서 AI 검색 수집기를 막지 않았다
- 숫자에 기준일이 있다
- 매달 같은 질문으로 결과를 기록한다
이 사이트에 적용한 것
이 사이트는 위 순서를 먼저 페이지 코드에 적용했습니다. 페이지마다 대표 주소와 고유 설명을 두었고, 회사 정보에는 사업부(DX·AD)와 확장 사업(FEZH·D2HOUSE)을 함께 적었습니다. 사업 소개·회사 소개·AI 페이지의 문답은 화면과 데이터가 같습니다. AI용 요약 llms.txt와 전체 사실 문서 llms-full.txt도 함께 올렸습니다. 이후 관리자 화면이 붙으면 제목·설명·문답·회사 정보를 화면에서 고치고, 같은 값이 구조화 데이터와 수집 파일에 함께 반영되도록 연결합니다.
기준 · 2026.10 디지털다임 홈페이지 GEO·SEO 설계 · 참고 schema.org(Organization·FAQPage) · llmstxt.org